LayerNorm w AI — co to jest Layer Normalization?
LayerNorm, czyli Layer Normalization, to technika normalizacji stosowana w sieciach neuronowych, w tym w modelach językowych opartych na architekturze transformerowej. Jej głównym zadaniem jest stabilizowanie wartości liczbowych przepływających przez kolejne warstwy modelu, tak aby uczenie i generowanie odpowiedzi były bardziej przewidywalne.
W dużych modelach AI tekst, obraz albo kod nie są przetwarzane jako słowa czy zdania w ludzkim sensie. Model operuje na reprezentacjach liczbowych. Każdy token jest zamieniany na wektor, czyli zestaw liczb opisujących jego znaczenie w danym kontekście. Te liczby przechodzą przez wiele warstw modelu. Jeżeli ich skala zacznie się zbyt mocno zmieniać, model może trenować się wolniej, niestabilnie albo generować gorsze wyniki.
LayerNorm pomaga utrzymać te wartości w uporządkowanym zakresie. Dzięki temu kolejne warstwy modelu otrzymują dane o bardziej stabilnej skali i mogą skuteczniej przetwarzać informacje.
Krótka definicja
LayerNorm to technika normalizacji, która stabilizuje wartości wewnątrz pojedynczej warstwy sieci neuronowej, aby model AI mógł trenować się i działać bardziej przewidywalnie.
W WordPressie ustaw ten fragment jako blok Pullquote.
Jak działa LayerNorm w prostych słowach?
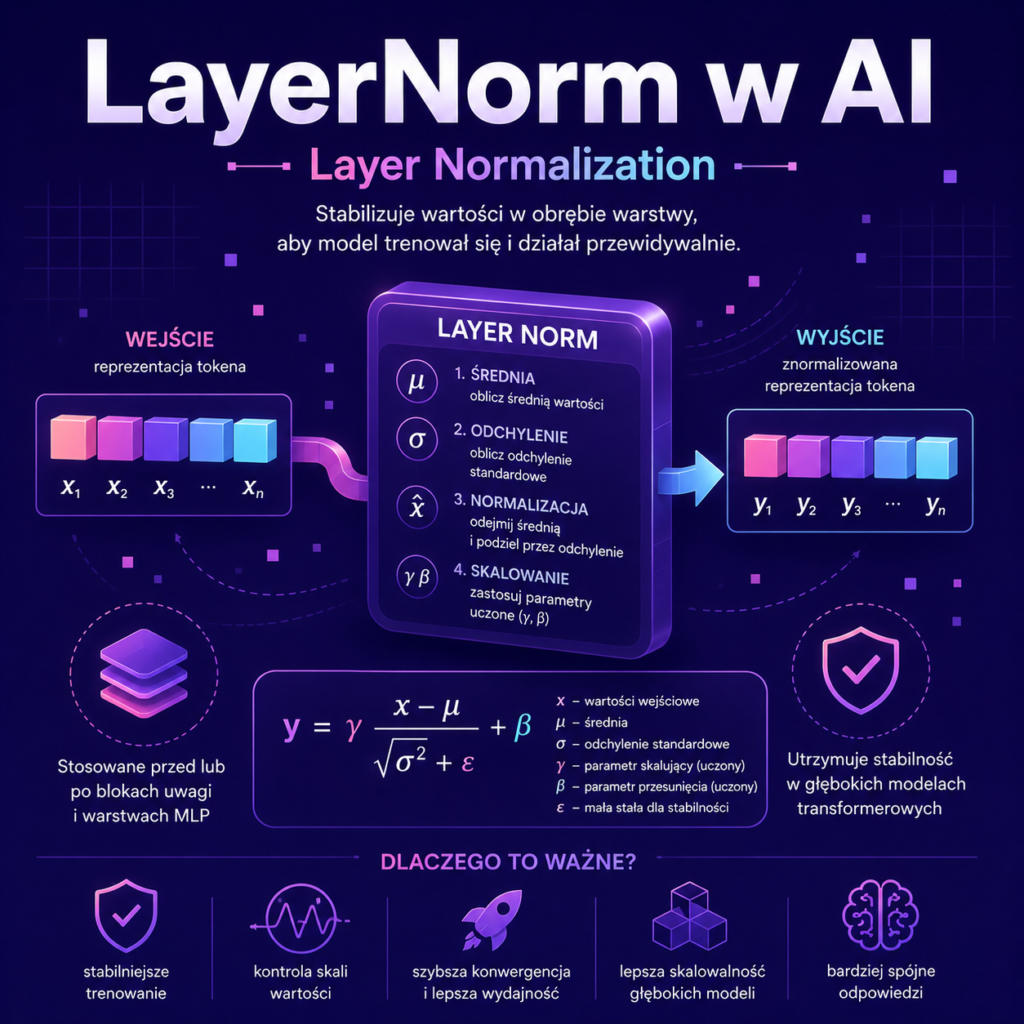
LayerNorm działa jak mechanizm wyrównujący wartości wewnątrz modelu. Gdy model przetwarza tekst, każda warstwa tworzy reprezentacje liczbowe. Te reprezentacje mogą mieć różną skalę: jedne wartości mogą być bardzo wysokie, inne bardzo niskie, a jeszcze inne rozproszone w sposób utrudniający dalsze obliczenia.
LayerNorm bierze wartości z danej warstwy i normalizuje je tak, aby miały bardziej kontrolowany rozkład. W uproszczeniu: odejmuje średnią, dzieli przez odchylenie standardowe, a następnie stosuje parametry uczone przez model. Dzięki temu normalizacja nie jest sztywnym przekształceniem, lecz może być dopasowywana w trakcie trenowania.
Można to porównać do porządkowania głośności wielu ścieżek dźwięku. Jeżeli jedna ścieżka jest zbyt głośna, a inna prawie niesłyszalna, całość staje się trudna do dalszej obróbki. LayerNorm nie usuwa informacji, ale reguluje skalę sygnału, aby kolejne elementy systemu mogły pracować stabilniej.
W modelach językowych LayerNorm zwykle pojawia się w wielu miejscach transformera: przed albo po mechanizmie uwagi oraz przed albo po warstwach feed-forward. Konkretne umiejscowienie zależy od architektury modelu. W praktyce spotyka się między innymi warianty określane jako Pre-LN i Post-LN. W układzie Pre-LN normalizacja znajduje się przed danym blokiem obliczeniowym, a w Post-LN po nim.
LayerNorm w AI — co to jest Layer Normalization?
Dlaczego LayerNorm jest ważne?
LayerNorm jest ważne, ponieważ głębokie sieci neuronowe są wrażliwe na skalę wartości przepływających przez warstwy. Duży model językowy może mieć dziesiątki, setki albo nawet więcej bloków obliczeniowych. Każdy z nich modyfikuje reprezentacje tokenów. Bez mechanizmów stabilizujących takie wartości mogłyby łatwiej narastać, zanikać albo zachowywać się w sposób utrudniający uczenie.
Dzięki LayerNorm modele AI mogą:
- stabilniej trenować się na dużych zbiorach danych,
- skuteczniej przekazywać informacje między warstwami,
- ograniczać problemy związane ze zbyt dużą lub zbyt małą skalą aktywacji,
- szybciej osiągać użyteczną jakość podczas treningu,
- lepiej zachowywać spójność obliczeń w głębokich architekturach,
- łatwiej skalować się do większej liczby warstw i parametrów.
LayerNorm nie odpowiada bezpośrednio za inteligencję modelu. Nie daje modelowi wiedzy, pamięci ani zdolności planowania. Jest jednak jednym z tych elementów technicznych, bez których trenowanie dużych modeli byłoby trudniejsze. Działa na poziomie matematycznej stabilności, ale jego skutki są widoczne w jakości końcowego systemu.
To dobry przykład mechanizmu, który użytkownik rzadko zauważa, a który ma duże znaczenie dla tego, czy model działa płynnie, przewidywalnie i skutecznie.
Gdzie wykorzystuje się LayerNorm?
LayerNorm jest szeroko wykorzystywany w architekturach opartych na transformerach. Pojawia się w modelach językowych, modelach multimodalnych, systemach przetwarzania obrazu, modelach do generowania kodu oraz wielu innych rozwiązaniach opartych na głębokich sieciach neuronowych.
W kontekście LLM-ów LayerNorm stosuje się szczególnie tam, gdzie ważne są:
- stabilne trenowanie dużych modeli,
- praca z wieloma warstwami transformera,
- skuteczne przetwarzanie reprezentacji tokenów,
- analiza długich sekwencji,
- generowanie tekstu,
- generowanie i analiza kodu,
- reasoning,
- systemy agentowe.
Warto odróżnić LayerNorm od mechanizmu uwagi. Attention pomaga modelowi ustalić, które tokeny są istotne względem innych tokenów. LayerNorm nie wybiera tokenów ani nie nadaje im znaczenia. Jego rola jest bardziej podstawowa: stabilizuje wartości, na których działają kolejne komponenty modelu.
Warto też odróżnić LayerNorm od RMSNorm. Obie techniki są metodami normalizacji, ale działają nieco inaczej. LayerNorm wykorzystuje średnią i wariancję, natomiast RMSNorm opiera się na pierwiastku ze średniej kwadratów wartości. RMSNorm można traktować jako prostszą i często bardziej efektywną obliczeniowo alternatywę, ale LayerNorm pozostaje jedną z najważniejszych technik normalizacji w historii współczesnych sieci neuronowych.
LayerNorm a era agentów AI
LayerNorm ma znaczenie dla agentów AI pośrednio. Agent AI to zwykle system zbudowany wokół modelu językowego, który może planować działania, korzystać z narzędzi, analizować dokumenty, wykonywać kroki pośrednie i reagować na wyniki wcześniejszych operacji. Jakość takiego agenta zależy nie tylko od logiki zewnętrznej, ale też od stabilności bazowego modelu.
Jeżeli model językowy niestabilnie przetwarza reprezentacje, agent może gorzej interpretować instrukcje, szybciej tracić spójność i częściej popełniać błędy w zadaniach wieloetapowych. LayerNorm pomaga utrzymać bardziej przewidywalne działanie modelu, szczególnie w głębokich architekturach, gdzie dane przechodzą przez wiele bloków obliczeniowych.
Nie oznacza to, że LayerNorm samodzielnie tworzy zdolności agentowe. Nie daje modelowi planowania, pamięci długoterminowej ani dostępu do narzędzi. Jest raczej jednym z fundamentów technicznych, które sprawiają, że model może być wystarczająco stabilny, aby pełnić rolę rdzenia systemu agentowego.
W praktyce agent AI potrzebuje wielu elementów: modelu językowego, pamięci, narzędzi, mechanizmu kontroli działania, dobrego promptowania i często zewnętrznych baz wiedzy. LayerNorm znajduje się głębiej — na poziomie architektury modelu. Jego wpływ jest pośredni, ale istotny.
Podsumowanie
LayerNorm to technika normalizacji stosowana w sieciach neuronowych i modelach transformerowych. Jej zadaniem jest stabilizowanie wartości liczbowych wewnątrz warstw modelu, aby uczenie i przetwarzanie informacji były bardziej przewidywalne.
W prostych słowach: LayerNorm pomaga modelowi utrzymać porządek w obliczeniach. Nie odpowiada za treść odpowiedzi ani za wybór najważniejszych tokenów, ale sprawia, że kolejne warstwy modelu mogą pracować na wartościach o stabilniejszej skali.
To jeden z podstawowych mechanizmów technicznych współczesnych modeli AI. Działa „pod maską”, ale ma duże znaczenie dla jakości trenowania, stabilności działania i skalowalności dużych modeli językowych. W świecie LLM-ów i agentów AI LayerNorm jest więc mniej widocznym, ale bardzo ważnym elementem architektury.